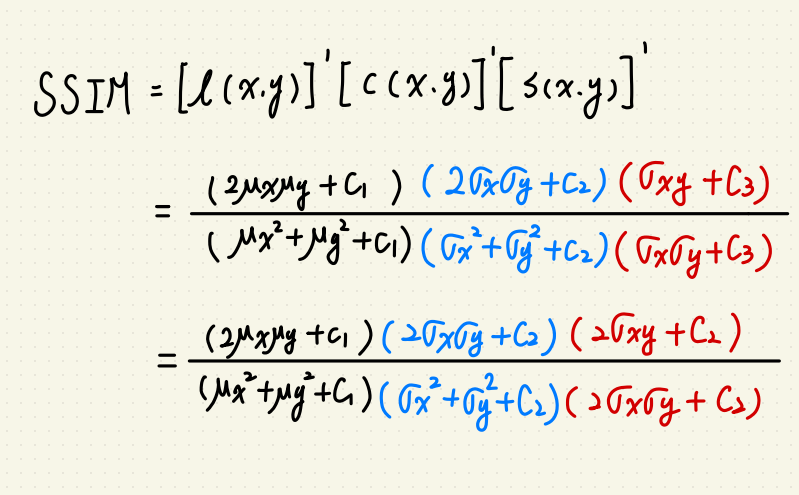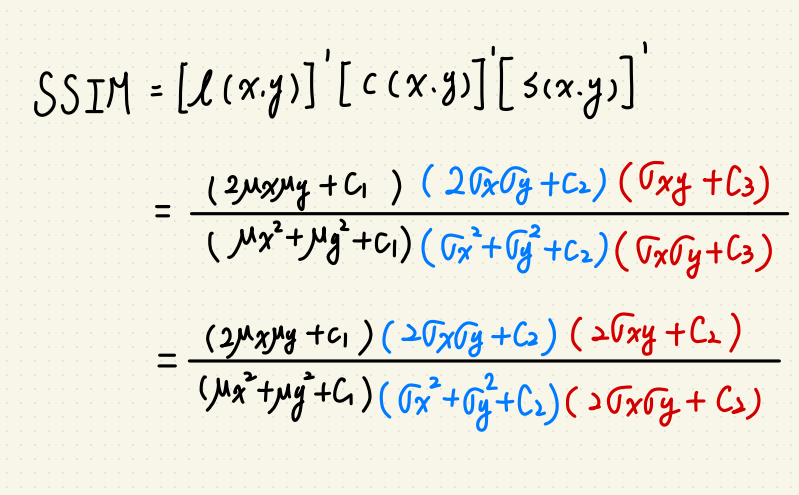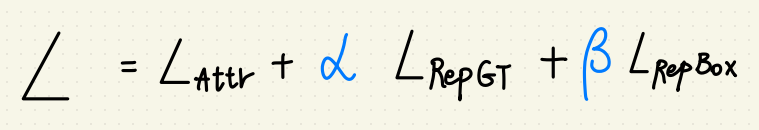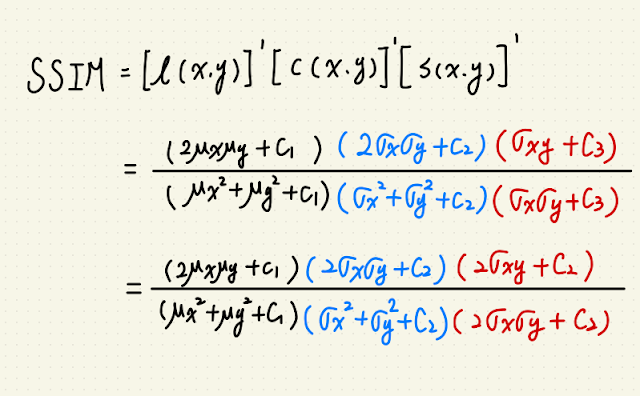
作者: wuyiulin

  • 不均勻光源下的優化 SSIM 演算法

    不均勻光源下的優化 SSIM 演算法


    這篇是 SSIM 系列第三篇,接續前篇 使用 PyTorch 實做 2D 影像捲積,

    要來談一下 SSIM 如何在不均勻光源下優化 SSIM。

    如果你是剛開始接觸 SSIM 的人,可能會跟我一樣看過一篇幫愛因斯坦去噪的實現文章。

    沒錯,當初我也是看到愛因斯坦的臉逐漸浮現,才覺得 SSIM 可以拿來解工程問題!

    只是愛因斯坦那篇的調節亮度方法對於工程來說太過理想化,

    問題在於他是把整張圖片的像素值乘以 0.9 調亮度!

    這樣的話 SSIM 算法裡面的變異數項是不會變的,只有考慮到平均數項,

    所以他做出來的 SSIM 值不會差太多。

    但是現實世界是很絢爛多彩且難以預測的,
    就像我前兩天載室友出門,停等紅燈時他突然發生奇怪的聲音,

    轉頭問他在幹麻?

    :我在跟你的機車排氣管對頻。

    實務上,我們可能會面對不均勻光源的問題,就像是街邊的燈光:

    這燈光很糟糕,比忘記簽聯絡簿的國小學童還糟糕,

    因為它的光源只會影響照片的一部分,而且還會隨著距離遞減。

    如果使用原版的 SSIM 方法對比這種有無開燈的照片,

    則 SSIM值會不可避免的大幅下降,

    但這兩張照片的前景內容物(e.g. 人、車、直升機、脫光衣服在路上奔跑的人)一樣對吧?

    所以在基於前景的情況下,有些時候我們會希望有無開燈的照片應該要一樣,

    數學上也就是得到理想值為 1 的 SSIM 值。

    (實在是繞口令,讓我想到事件攝影機。)

    要解這個問題就要先了解 SSIM 的本質,

    SSIM 是由 sliding window 來解圖片中各自區域均值、變異數,還有兩張圖片的共變數所構成。

    而二維的 window 又是由一維的 kernel (通常是 Gaussian)矩陣相乘得到,

    基本上 OpenCV 裡面提供的方法是這樣:

    nkernel = cv2.getGaussianKernel(11, 1.5)
    nwindow = np.outer(nkernel, nkernel.transpose())
    

    往 cv2.getGaussianKernel 裡面看,我們可以知道這條函式來自 getGaussianKernelBitExact:

    再往 getGaussianKernelBitExact 裡面看:

    重點是 158, 181 行運算的兩個迴圈,他們在幫忙算高斯核並歸一化。

    我們的重點是歸一化,以前的簡易版 OpenCV Source Code 大概長這樣:

    def getGaussianKernel(M, std):
        n = np.arange(0, M) - (M - 1.0) / 2.0
        sig2 = 2 * std * std
        w = np.exp(-n ** 2 / sig2)
        muli = 1/sum(w[:])
        wn = w * muli
    
        return wn
    

    這種歸一化的一維高斯核長得像是:

    扁扁有點可愛,像是軟趴趴的史萊姆。

    歸一化的好處是能夠保證像素值永遠恆等(因為也只是重新分配)。

    但是這樣可能會造成一些問題,

    想像一下你是該像素當事人站在 X=5 的位置,
    現在要過年了,大家手上都有一筆要發出去的紅包錢,俗稱紅包預算。
    假設你的紅包預算是一萬塊:

    X=5 是你自己,辛苦了一整年,你決定給自己紅包預算 * 0.26 倍,恭喜獲得 2600 元。
    X=4, X=6 這個漢明距離為一的,是你的父母,得到他們的紅包預算 *0.21 倍;
    X=3, X=7 這個漢明距離為二的,是你的手足,得到他們的紅包預算 *0.10 倍;
    一路發下去,你會發現不管身邊的人多有錢,你最多只會得到原來的一萬xD
    因為你早就被歸一化了!
    這種 SSIM 分配框架下,就會產生很多問題,例如:
    你跟小明是同事,都有一萬塊的紅包預算。
    你身邊的人都很有錢,分完紅包你還有一萬塊;
    但是小明就不一樣了,他身邊的人都超窮,分完紅包後他只剩兩千六。

    小明知道這件事情後,會不會沒事就想從背後捅你這個好野死囝仔?
    這就會造成很多社會問題,因為貧富差距(變異數)過大。
    要怎麼解決這個問題呢?

    讓我們看看非歸一化的原始高斯核:

    這個版本就好多了,
    無論小明身邊的人再怎麼窮,他始終可以拿回自己的紅包預算一萬塊,
    剩下的都是多的。
    於是小明跟你的貧富差距就減少了(某種程度上減少變異數),
    所以這個問題就得到了緩解。
    結論:

    如果要讓兩張前景相同,
    但是其中一張有受燈光(或是部份遮罩影響)的圖片做 SSIM 計算,
    使用非歸一化的高斯核可以有效提昇 SSIM 值。

    以下附上我的實驗源碼:

    def ourGaussianKernel(M, std):
        n = np.arange(0, M) - (M - 1.0) / 2.0
        sig2 = 2 * std * std
        w = np.exp(-n ** 2 / sig2)
        # muli = 1/sum(w[:])
        # wn = w * muli
    
        return w
    
    def ssim_Normalized(img1, img2):
        C1 = (0.01 * 255)**2
        C2 = (0.03 * 255)**2
    
        img1 = img1.astype(np.float64)
        img2 = img2.astype(np.float64)
        nkernel = cv2.getGaussianKernel(11, 1.5)
        nwindow = np.outer(nkernel, nkernel.transpose())
        nmu1 = cv2.filter2D(img1, -1, nwindow)[5:-5, 5:-5]
        nmu2 = cv2.filter2D(img2, -1, nwindow)[5:-5, 5:-5]
        nmu1_sq = nmu1**2
        nmu2_sq = nmu2**2
        nmu1_mu2 = nmu1 * nmu2
        nsigma1_sq = cv2.filter2D(img1**2, -1, nwindow)[5:-5, 5:-5] - nmu1_sq
        nsigma2_sq = cv2.filter2D(img2**2, -1, nwindow)[5:-5, 5:-5] - nmu2_sq
        nsigma12 = cv2.filter2D(img1 * img2, -1, nwindow)[5:-5, 5:-5] - nmu1_mu2
        nssim_map = ((2 * nmu1_mu2 + C1) *
                    (2 * nsigma12 + C2)) / ((nmu1_sq + nmu2_sq + C1) *
                                           (nsigma1_sq + nsigma2_sq + C2))
        return nssim_map.mean()
    
    def ssim_Unnormalized(img1, img2):
        C1 = (0.01 * 255)**2
        C2 = (0.03 * 255)**2
    
        img1 = img1.astype(np.float64)
        img2 = img2.astype(np.float64)
        kernel = ourGaussianKernel(11, 1.5)
        window = np.outer(kernel, kernel.transpose())
        mu1 = cv2.filter2D(img1, -1, window)[5:-5, 5:-5]
        mu2 = cv2.filter2D(img2, -1, window)[5:-5, 5:-5]
        mu1_sq = mu1**2
        mu2_sq = mu2**2
        mu1_mu2 = mu1 * mu2
        sigma1_sq = cv2.filter2D(img1**2, -1, window)[5:-5, 5:-5] - mu1_sq
        sigma2_sq = cv2.filter2D(img2**2, -1, window)[5:-5, 5:-5] - mu2_sq
        sigma12 = cv2.filter2D(img1 * img2, -1, window)[5:-5, 5:-5] - mu1_mu2
        ssim_map = ((2 * mu1_mu2 + C1) *
                    (2 * sigma12 + C2)) / ((mu1_sq + mu2_sq + C1) *
                                           (sigma1_sq + sigma2_sq + C2))
        return ssim_map.mean()
    if __name__=='__main__':
        img1_path = 'img1.png'
        img2_path = 'img2.png'
        kernelSize = 21
        light = list(map(np.uint8, gkern(kernlen=kernelSize, std=1.5)*100))
        img1 = np.random.randint(0, 150, size=(100, 100)).astype(np.uint8)
        img2 = np.zeros_like(img1)
        img2[:] = img1[:]
    
        row = np.random.randint(int(kernelSize/2), img1.shape[0] - int(kernelSize/2))
        col = np.random.randint(int(kernelSize/2), img1.shape[1] - int(kernelSize/2))
        times = np.random.randint(1, 100)
        for i in range(0, times):
            img2[row:row + kernelSize, col:col + kernelSize] += light
        img2 = np.clip(img2, 0, 255)
        
        print("This is Normalized): " + str("{:.5f}".format(ssim_Normalized(img1, img2))))
        print("This is Unnormalized): " + str("{:.5f}".format(ssim_Unnormalized(img1, img2))))
    

    親測可用:

    有任何問題或筆誤歡迎聯繫我:wuyiulin@gmail.com

  • [面試] 瑞鼎 – 觸控演算法工程師面試紀錄

    2023 – 11

    瑞鼎 – 觸控演算法工程師

    工作內容

    1. 客戶需求專案支援
    2. 觸控演算法開發與維護
    3. 觸控演算法數據分析

    職務類別

    演算法工程師


    白板題


    Q1-1. 不使用 size of 算出這個結構佔用記憶體大小

    struct ST
    {
        int I;
        float F;
    }AA;


    解答:

    struct ST
    {
        int I;
        float F;
    }AA;
    
    int mysize(struct ST* a)
    {
        return (char*)(a + 1) - (char*)a;
    }
    
    int main()
    {
        AA.I = 10;
        AA.F = 4.5;
        printf("Size of AA: %dn", mysize(&AA));
        return 0;
    }
    
    
    Terminal:
    Size of AA: 8
    

    可以這樣解的原因是結構變數指標+1 就是獲得這個結構變數後的記憶體位置,

    用 char* 算是因為 char 佔用 1 Byte。


    Q1-2. 用 C 實現 $ sum_{x=0}^{2} frac{2^{x}e^{x-1}}{32}$,不能使用 division,

                並把整數與浮點數部份分別存入 AA 結構。 

                        ($e^{-1}=0.367879, e^{0}=1, e=2.718281$)


    解答:

    #include <stdio.h>
    #include <stdlib.h>
    #include <math.h>
    
    struct ST
    {
        int I;
        float F;
    }AA;
    
    
    int main()
    {
        int size = 3;
        float *exp = malloc((size + 1) * sizeof(float));
        exp[0] = 0.367897;
        exp[1] = 1.0;
        exp[2] = 2.718281;
        exp[3] = 0.0;
        
        for(int x=0; x<size; x++)
        {
            float bx = 2.0;
            bx = pow(bx, (x-5));
            exp[size+1] = exp[size+1] + bx*exp[x]; 
        }
        
        AA.I = (int)exp[size+1];
        AA.F = exp[size+1] - AA.I;
        
        printf("Result int part: %d, float part: %f", AA.I, AA.F);
        
        return 0;
    }
    
    Terminal:
    Result int part: 0, float part: 0.413782
    

    除了那個 pow 的 MATH.h 不太確定能不能用外,

    其他東西還蠻直覺的。

    Q2.利用指標反轉陣列 array arr[7] ={1,2,3,4,5,6,7}


    解答:

    void swap(int *head, int *tail)
    {
        *head = (*head)^(*tail);
        *tail = (*head)^(*tail);
        *head = (*head)^(*tail);
    }
    
    
    int main()
    {
        int arr[7] = {1,2,3,4,5,6,7};
        int *head = &arr[0];
        int *tail = &arr[6];
        
        while(head<tail)
        {
            swap(head, tail);
            head++;
            tail--;
        }
        for (int i = 0; i < 7; i++)
        {
            printf("%d ", arr[i]);
        }
        
        return 0;
    }
    
    Terminal:
    7 6 5 4 3 2 1


    Q3. array arr={1,3,5,7,9,11,13,17} ,用二分搜尋法找出 11 的 index 為何?


    解答:

      
    int find(int* arr, int H, int T, int target)
    {
        if(H==T) {return H;}
        
        if (target < arr[(int)((H + T)/2)])
        {
            return find(arr, H, (int)((H + T)/2), target);
        }
        else
        {
            return find(arr, (int)((H + T)/2)+1, T, target);
        }
    }
    
    
    int main()
    {
        int arr[8] = {1,3,5,7,9,11,13,17};
        int target = 11;
        int res = find(arr, 0, 7, 11);
        printf("Index of 11: %d", res);
        return 0;
    }
    
    Terminal:
    Index of 11: 6
    

    Q4.下面這段函式定義是否合法? 

    Q5.為什麼它合法或不合法?

      
    int* fun(int *x){return &x*&x;}
    float* fun(float *x){return &x*&x;}
    
    int main()
    {
        int x1 = 4;
        float x2 = 4.5;
        int* result1 = fun(x1);
        float* result2 = fun(x2);
        return 0;
    }
    

    解答:

    Q4 不合法

    Q5 主要有兩個原因:

            第一個是沒給編譯器定義,這關係到函式多載(Function Overloading),

            在 C 裡面就不允許函式多載、不同 IO 共用同一個函式名稱,

            在 CPP 的話就允許,但是這邊沒說到用 gcc or g++ 編譯。


            第二個是指標觀念,當函式傳入 *x,則函式內的 &x 等價 **x。

            雙重指標 **x 沒有辦法直接做乘法運算。

    心得

    現場我有把 Q2, Q3 解出,

    Q1-1肯定是我自己寫錯,Q1-2 第一眼看成積分直接空白,回來越想越不對。

    Q4, Q5 可能是我 CPP 寫太多直覺以為只考函式多載,就騰了合法兩字送出,

    還大膽解釋了一下。

    沒想到裡面還有藏指標(汗。

    以上都是英文出題,但是我沒記好英文全文,所以就憑自己印象寫出來,

    如有筆誤歡迎來信指正。

    這次是 104 主動投遞,人資主動打來約時間,

    我也問了在職的話能不能一面線上?

    結果是要到新竹現場考試,也通知筆試沒過就不面試。

    行前還要我準備碩論跟部落格的報告。

    這次整個面試流程大概是我提早半個小時到瑞鼎,

    櫃台帶我去一樓小房間,

    約定時間快到時,一位看起來像是人資(?)的人進來發考卷說寫半小時。

    考完後人資將考卷拿給主管批改,過大概二十分鐘下來說我沒過資格,

    還問我會不會出去?

    OS:這不廢話嗎?不然你以為我怎麼出現在這裡?

             嚴重懷疑你有特異功能看得到我的隱形直昇機或是隱形任意門。

    雖然回家想想自己解得不甚理想,但是從頭到尾都沒見到主管這點讓我有點火大。

    準備了一堆東西連主管都沒見著,幹麻不讓我線上開筆記本實況寫程式就好了?

    以上。

  • ZLUDA 收官之戰 – 它還只是個孩子啊!

    ZLUDA 收官之戰 – 它還只是個孩子啊!

    承上文:

    ZLUDA 拓荒之路 – 榨乾 Intel CPU 算力的中短期方案


    先說結論:

    ZLUDA 目前在我的環境測試起來並不支援一些好棒棒框架,

    像是 PyTorch、Numba 之類的,雖然我沒有測試,但是有足夠信心認為 Tenserflow 也不支援。

    先附上我的環境:

    OS: Ubuntu 22.04

    Intel GPU: UHD 770

    我的測試方式是下載 ZLUDA 的 Releases 2 的版本

    這個解開會有一個資料夾內含兩個 .so 檔,

    將想執行的檔案放在與 .so 檔同個資料夾下執行即可。

    但是像作者一樣測試 GeekBench 5.2.3 的話是會過的,

    數據差別不大,至於為什麼測出沒有 Sobel 測項?

    因為要有那個測項要付錢啊啊啊啊啊!
    (GeekBench 5.2.3 官網下載點)

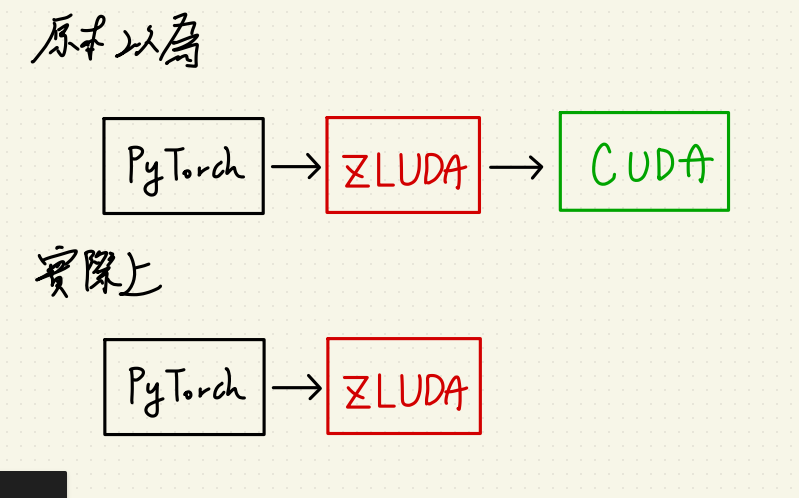
    接著我要勘誤上篇關於 CUDA 與 ZLUDA 的引用關係,

    後來發現 ZLUDA 使用上應該是要完全取代 CUDA 的,

    所以你不裝 CUDA 它也會跑得起來。

    但由於 ZLUDA 並沒有支援 CUDA 的所有功能,

    加上我猜測它是針對某版的 CUDA 來開發的,

    所以 API 串接那邊也會報錯,而 CUDA 本家會動態連結這些函式,

    導致 ZLUDA 的支援性很低。

    最後來談談這東西的未來性還有有志之士可以怎麼發展下去?

    我認為這東西會踩到 Intel 把拔的 oneAPI 計畫,

    短時間內應該就這樣了。

    所以除非有誰與 Nvidia, Intel 同時具有競爭關係又做 CPU + GPU?

    ZLUDA 才會復活。

    (望向蘇媽)

    有志之士的話可以接著試試看,

    因為我曾經在 Python 3.7 及上述環境中讓 Numba 呼叫到 Intel UHD 770 的硬體。

    以下是給有志之士的簡易指南:

    1.確認自己手上有(消費級 Intel CPU 超過 8代 或  Intel XE CPU)且 (有內顯)

    2.裝 Intel 內顯驅動(Ubuntu 20.04 可以參考這篇, 22.04 也可以參考但記得不用降內核)

    3.確認內顯驅動有裝好xD

    4.裝 Python3.7 + Numba 0.49 – 0.58 版本,我印象當時是裝這區間。

    5.下載 ZLUDA 的 Releases 2 的版本 來測試

    裝驅動的時候要特別注意,

    我在那邊卡很久,不一定第一次會裝好,

    重複裝的時候不要反安裝到這個 gawk libc6-dev udev,

    這套件就算你不 –purge 都會幫你把 Gnome 還有一拖拉庫東西 拆掉 :)

    最後講一下 Intel 的 oneAPI,

    我用過裡面的 Intel® oneAPI Base Toolkit + Intel® AI Analytics Toolkit(PyTorch 最佳化)

    用同一台機器來計算同一份呼叫到 PyTorch 的檔案,

    用 Intel 方案的環境會算得比純 PyTorch 版本還要慢。

    就是大家可以收一收回家了,感謝各位。

    如果有志之士想討論 or Intel 官方想維護一下自己的東西(#。

    歡迎聯絡我:

    wuyiulin@gmail.com

  • ZLUDA 拓荒之路 – 榨乾 Intel CPU 算力的中短期方案


    在開始壞壞之前,我們先了解一下 ZLUDA 是什麼?

    ZLUDA 是一款很有理想的開源套件,

    號稱能模擬閉源的 CUDA ,只用 Intel CPU 就能執行現有的 CUDA code。

    但實際用下去發現還是有一點小限制,

    畢竟作者本人在 2021 年跳坑了(用膝蓋猜是被 I社把拔的 Arc 顯卡利益衝突到)。

    目前 Linux 系列只支援到 5.19 Kernel,

    如果你跟我一樣用 Ubuntu 22.04 也是失去支援。

    Windows 戰場就優質許多,

    只要你是臺正常的家用主機應該都能用!

    畢竟這年代誰還用奔騰與賽揚或是 Atom 當家用 CPU 你說對吧?

    但還是跟一票嵌入式 CPU 說掰掰了,

    因為 ZLADA 主要壓榨的是 UHD 顯示晶片的算力。

    話不多說,先來下載在 windows 上面用:

    下載連結

    下載完解壓縮,你的框架套件(PyTorch 等)也不用重裝,

    就直接:

    zluda_wuth.exe -- python your_py_file.py

    就能跑了,484很方便?

    Ummmm,通常是不會那麼方便啦。

    有幾點要特別注意,因為這貨是模擬 CUDA 所以不是真的尻 CUDA 出來用。

    你的框架套件配合 CUDA 版本要看 nvidia-smi 上面你裝的 Nvidia Driver 支援的比較準,

    而不是 nvcc -V 出來的真實 CUDA 版本。

    不然注入 zlida_with.exe 的時候會說你的 Driver 與 CUDA mismatch。

    聽起來有點模糊對不對?

    簡單來說,

    如果你下 nvidia-smi 發現自己 Nvidia Driver 是 53X.xx 版,配合的 CUDA 是 12.2,

    而 nvcc -V 出來的真實 CUDA 版本是 10.0?

    那麼你 PyTorch 就要按照 Nvidia Driver 配合的 CUDA 裝,而不是裝 cu100 系列的 PyTorch。

    這點要特別注意!

    還有就是如果在 conda 環境內遇到 Python3.8 的 dll loss 問題,

    需要重新安裝 Python ?

    切記在 conda 裡面重新安裝 Python ,套件會繼承下來,

    這會與之前舊有的 PyTorch 連動產生一些問題。

    像是好事的 PyTorch 1.8.1 會喜歡幫你更新 typing_extensions,

    如果你重新安裝了低版本的 Python (e.g. 3.8 -> 3.7)

    會遇到 typing_extensions 錯誤,而且長得很像你程式寫錯:

    File “C:UsersuserNameanaconda3envsmyenvlibsite-packagestyping_extensions.py”, line 874
        def TypedDict(typename, fields=_marker, /, *, total=True, **kwargs):
                                                ^
    SyntaxError: invalid syntax


    莫急莫慌莫害怕,先查一下 typing-extensions 版本是不是被繼承?

    是的話直接:

    pip show typing-extensions
    pip uninstall typing_extensions
    pip install typing_extensions
    

    我印象還因為 zluda 處理了一些 deadlock 問題,

    還好天公疼憨人讓我順手解開了。

    以上就能讓 ZLUDA 在 Windows 上順利跑起來!

    結論時間:

    ZLUDA 真的能取代低階 GPU (_050, _060)的 inference task 嗎?

    以下情況是拿 Alder Lake 的 i5 去測的結論,

    某些情況會比純 CPU inference 快一點,

    但要 Costdown 還是想多了。

    有進步,但不多!

  • 使用 PyTorch 實做 2D 影像捲積

    使用 PyTorch 實做 2D 影像捲積

     承上篇:Structural Similarity(SSIM) 的 PyTorch 實現

    由於我 3D 影像處理做太多(X) 2D 影像處理還沒有恢復記憶(O)

    上次在刻高斯濾波的時候忘記 PyTorch Kit 的 Convolution 一個很重要的特性:

    PyTorch 會參考其他通道的資訊啊!

    其實這點也是無可厚非,畢竟 PyTorch 的初衷是給深度學習用的框架,

    韓信點兵多多益善嘛!

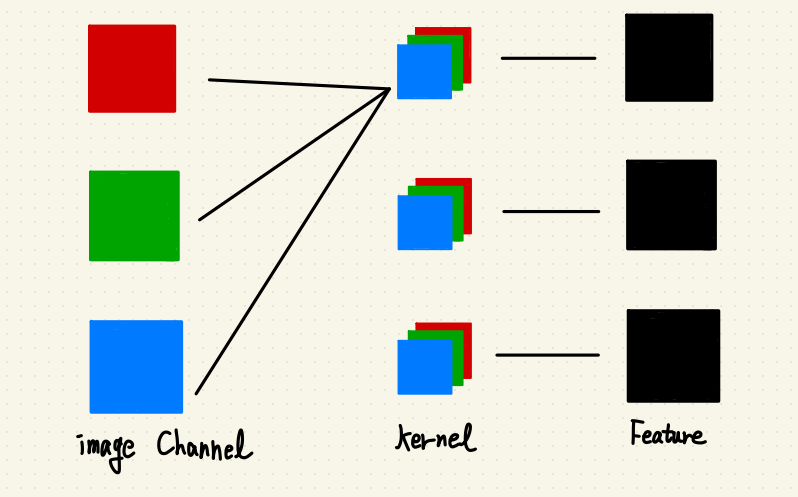
    所以 PyTorch 的 Convolution 流程大概是這樣:

    顯而易見地,沒經過額外處理的話 SSIM值會超出邊界(0,1),

    這違反了 SSIM 這項指標的意義。

    所以我們要來看一下隔壁棚 2D影像處理套件 – OpenCV 怎麼做 2D 影像的 Convolution?

    在 OpenCV 裡面,每個通道都是用同一顆 Kernel,但是會分離通道做 Convolution,

    如下圖:

    得到這個資訊後,我打算用分 Groups 來解這題。

    PyTorch 中的 2D Convolution 有兩種,

    一種是 torch.nn.Conv2d

    另一是 torch.nn.functional.conv2d

    前者只要設定好 Kernel 大小就能動,後者則可以提供使用自己 Kernel 的 API。

    筆者這次使用後者,就以後者的 Document 來解釋:

    首先我們要知道自己要分幾組 Group?

    我們希望每個通道都各自做 Convolution ,而 RGB 圖片有三個通道,

    所以我們的 Groups 應該設定三組。

    再來需要注意上圖中 torch.nn.functional.conv2d 中的 weight,

    這裡的 weight 代表的是 Kernel。

    既然改了 Groups ,Kernel 的相應尺寸也要記得改變。

    原本是 Kernel.shape = {3, 3, H, W} 要變成 {3, 3/3 = 1, H, W}。

    這樣就能開心地模擬 OpenCV 的 2D Convolution 啦!

    筆者在手刻 Kernel 的時候也遇到一些光怪陸離的問題,

    預計下一篇會來寫這部份。

  • LeetCode 解題紀錄  221. Maximal Square 圖片中最大的正方形

    LeetCode 解題紀錄 221. Maximal Square 圖片中最大的正方形

    繼 200. Number of Islands 後,又遇到一個影像處理的問題。

    這題要用動態規劃來解,菜雞如我第一時間沒想到動態規劃,

    但是後來也自己解出來了,紀錄一下我的解題心路歷程。

    題目簡介:

    給你一張尺寸為 m x n 像素且只包含(0,1)的圖片稱為 Matrix ,

    其中 1 代表有像素的區域,找出此張圖片中含有 1 的最大正方形區域面積。

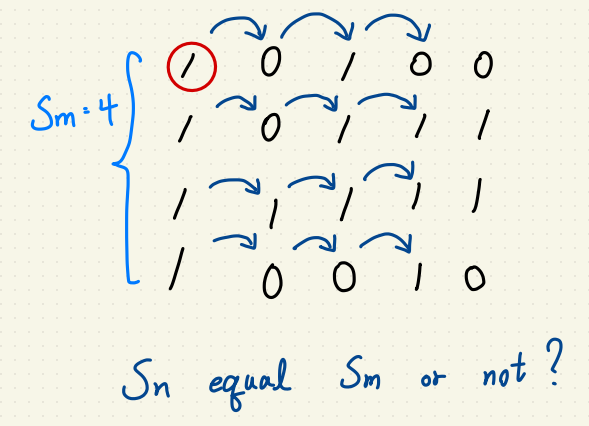
    第一階段想法:循序檢測法

    把每個點都當作候選正方形的左上角,

    先求 Row 再驗證每個 Col 是否符合正方形區域預想?

    若有,就回傳正方形區域面積;
    若無,就回傳 0。

    假設圖片中有 N 個元素,這個想法的時間複雜度為:

    $$O(N^{2})$$

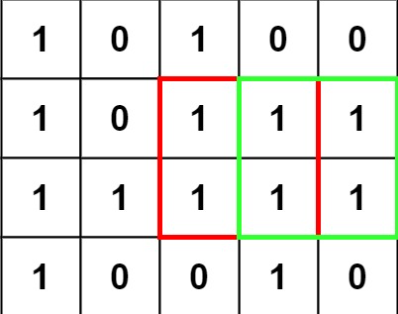
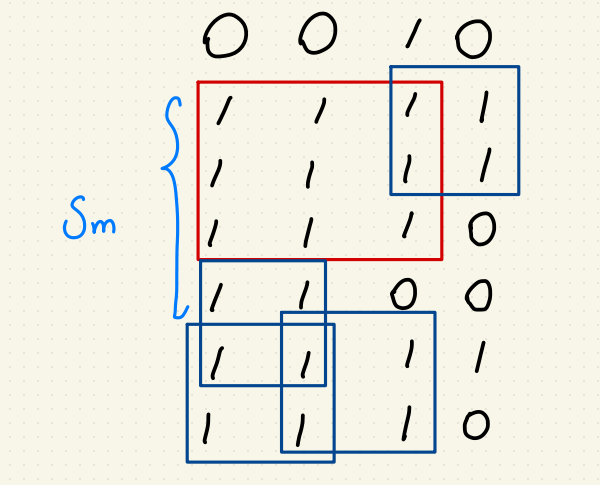
    但是我們會遇到一個特殊情況,當最大正方形在驗證失敗的候選正方形的的情況,

    像是:

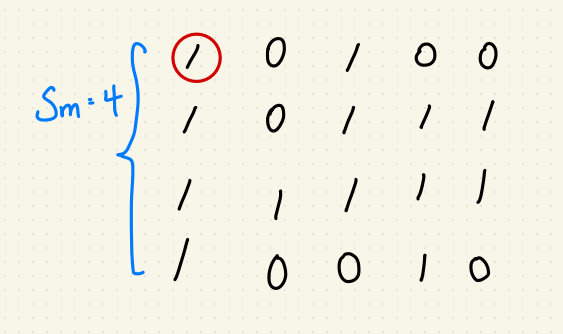
    就很尷尬,其中 $$S_m$$ 不等於 6 的原因是本圖中最大正方形是交由 min(m, n) 決定,

    所以不用檢查到 $$S_m = 6$$ 可以降低計算時間。

    結果:Wrong Answer

    第二階段:動態規劃法

    所以我決定再不增加時間複雜度的情形下,由小到大、每個正方形都檢測。

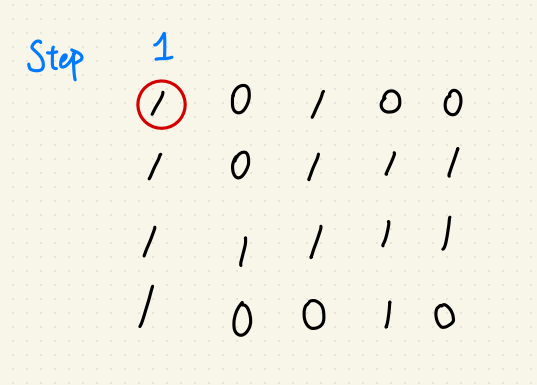
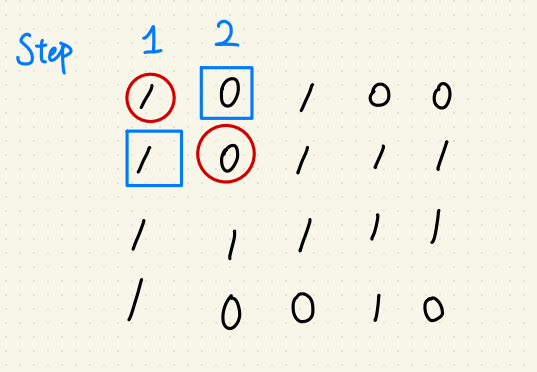
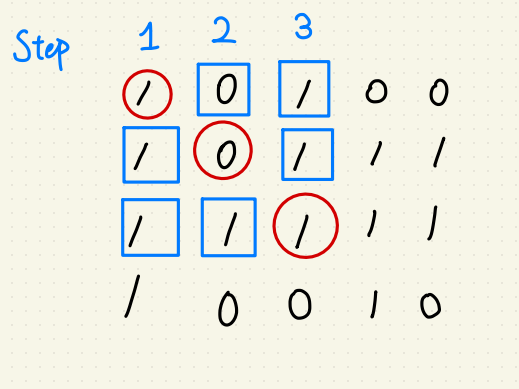
    使用動態規劃,每一步驟又拆成兩小步:

    第一步:驗證對角線是否為 ‘1’ ?

    第二步:驗證相應 X, Y軸是否為 ‘1’ ?

    若有任一步檢測到 ‘0’ ,則回傳步數 S 的平方當作正方形面積。

    不過鑑於這個作法時間複雜度遇到 Worst Case (全為 ‘1’ 的圖片時)仍為 $$O(N^{2})$$

    結果:Time Limited Error

    第三階段:利用影像(數據)特性降低時間複雜度。

    問自己一個問題:最低滿足圖片中最大正方形的條件是什麼?


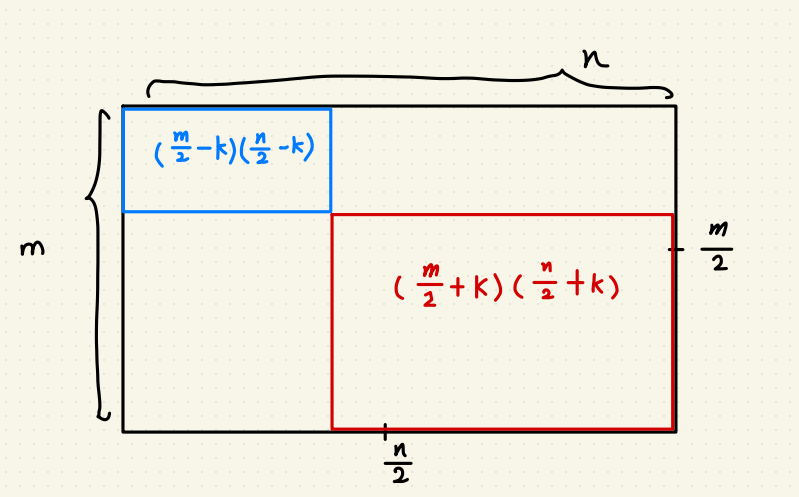
    答案是任何大於(長/2)*(寬/2)的正方形,

    因為本題目中不考慮重疊問題,所以用數學上來說:

    一圖片尺寸為 m*n ,若有任意正方形面積大於(m/2 + k)(n/2 + k),

    而 k 恆大於零的話,此正方形為圖片中最大的正方形就成立。

    而候選次大正方形面積必定為(m/2 – k)(n/2 – k),

    所以每個點出發後,

    檢測 (m*n/4) + m + n – 1 個像素就知道這個正方形是不是最大的了。

    結果:Accept

  • Structural Similarity(SSIM) 的 PyTorch 實現

    Structural Similarity(SSIM) 的 PyTorch 實現

    SSIM 是一種指標,用於比較兩張圖的相異程度。

    指標主要參考三個面向:

    • 亮度 Luminance

      $$l(xy) = frac{2mu_xmu_y+C1}{mu^2_xmu^2_y+C1}$$

    • 對比度 Contrast

      $$c(xy) = frac{2sigma_xsigma_y+C2}{sigma^2_xsigma^2_y+C2}$$

    • 結構相似度 Structure

      $$s(xy) = frac{sigma_{xy}+C3}{sigma_xsigma_y+C3}$$

    以上的 $$C1 = K_1l^2, C2 = K_2l^2,C3 的部份可以簡化為 C3 = frac{C2}{2}$$

    $$k_1 = 0.01, k_2 = 0.03, l  則為圖片的灰度值。$$

    整體的 SSIM 為三項相乘:

    $$SSIM(x,y) = [l(x,y)]^alpha[c(x,y)]^beta[s(x,y)]^gamma$$

    在這邊 $$alpha, beta, gamma $$ 都簡化為 1。

    這樣我們就可以簡化 SSIM 為:

    然後我看到其他人有用 Numpy 實現,

    就想著是不是自己能寫一版 PyTorch 來用?

    大概會遇到兩個問題:

    1.手刻 Gaussian Kernel 要塞在哪?

    2.轉換資料至 GPU 上的時候會有誤差。

    第一個問題當然是不能用 torch.nn.Conv2d() 來解,

    因為這個 API 不能自己定義 Kernel,而且我們不希望這個 Kernel 的權重跑掉。

    (Doc在此)

    所以我們要用 torch.nn.functional.conv2d 

    (Doc在此)

    接著我們要手刻一下 Gaussian Kernel:

    
    def gaussian_fn(M, std):
        n = torch.arange(0, M) - (M - 1.0) / 2.0
        sig2 = 2 * std * std
        w = torch.exp(-n ** 2 / sig2)
        return w
    def gkern(kernlen=256, std=128):
        """Returns a 2D Gaussian kernel array."""
        gkern1d = gaussian_fn(kernlen, std=std) 
        gkern2d = torch.outer(gkern1d, gkern1d)
        return gkern2d


    這個方法我是從這邊看來的,

    簡單來說就是從 1d Gaussian 用矩陣乘法造 2d Gaussian。

    把整體程式碼寫出來:

    
    def gaussian_fn(M, std):
        n = torch.arange(0, M) - (M - 1.0) / 2.0
        sig2 = 2 * std * std
        w = torch.exp(-n ** 2 / sig2)
        return w
    
    def gkern(kernlen=256, std=128):
        """Returns a 2D Gaussian kernel array."""
        gkern1d = gaussian_fn(kernlen, std=std) 
        gkern2d = torch.outer(gkern1d, gkern1d)
        return gkern2d
    
    def ssim_torch(img1, img2, kernel_size=11):
        start_time = time.time()
        C1 = (0.01 * 255)**2
        C2 = (0.03 * 255)**2
        transf = transforms.ToTensor()
        
        guassian_filter = gkern(kernel_size, std=1.5).expand(3, 1, kernel_size, kernel_size)
        H, W, C = img1.shape[0], img1.shape[1], img1.shape[2] 
        img1, img2 = torch.from_numpy(img1), torch.from_numpy(img2)
        img1B, img1G, img1R = img1[:,:,0], img1[:,:,1], img1[:,:,2]
        img2B, img2G, img2R = img2[:,:,0], img2[:,:,1], img2[:,:,2]
        img1B, img1G, img1R = img1B.unsqueeze(0), img1G.unsqueeze(0), img1R.unsqueeze(0)
        img2B, img2G, img2R = img2B.unsqueeze(0), img2G.unsqueeze(0), img2R.unsqueeze(0)
        img1 = torch.cat((img1B, img1G, img1R), dim=0).unsqueeze(0).float()
        img2 = torch.cat((img2B, img2G, img2R), dim=0).unsqueeze(0).float()
    
        mu1 = F.conv2d(img1, weight=guassian_filter, stride=1, groups=3)
        mu2 = F.conv2d(img2, weight=guassian_filter, stride=1, groups=3)
        mu1_sq = mu1**2
        mu2_sq = mu2**2
        mu1_mu2 = mu1 * mu2
        sigma1_sq = F.conv2d(img1**2, weight=guassian_filter, stride=1, groups=3) - mu1_sq
        sigma2_sq = F.conv2d(img2**2, weight=guassian_filter, stride=1, groups=3) - mu2_sq
        sigma12 = F.conv2d(img1 * img2, weight=guassian_filter, stride=1, groups=3) - mu1_mu2
        ssim_map = ((2 * mu1_mu2 + C1) *
                    (2 * sigma12 + C2)) / ((mu1_sq + mu2_sq + C1) *
                                           (sigma1_sq + sigma2_sq + C2))
        print("This is torch_SSIM computer time: " + "{:.3f}".format((time.time()-start_time)))
    
        return ssim_map.mean().detach().numpy()


    這邊的 sigma_sq 是先把元素數量 N 提出來,

    看起來有點不直覺要想一下。

    如果你跟我一樣追求效率,就會想把 tensor.Tensor 轉成  tensor.Tensor.cuda 拿來加速。

    這樣會遇到兩個小問題:

    • 在單張圖片(2592 x 1520)下,轉成  tensor.Tensor.cuda 反而比較慢。
    • 轉換後兩張相同圖片精度不是 1。

    第一個小問題應該是轉換時間差,

    第二個問題應該是 CPU 轉 GPU 的 tensor Loss。

    結論:

    • 在單張圖片下, PyTorch 版本的 SSIM 演算法速度會比 Numpy 快兩倍。 
    • 如果圖片不多,可以用 PyTorch(CPU) 轉比較快。

    Ref.

    https://stackoverflow.com/questions/60534909/gaussian-filter-in-pytorch

    https://blog.csdn.net/a2824256/article/details/115013851

    附上 Github Repo

    如何對本文有任何疑問或書寫錯誤,

    歡迎留言或是聯絡我:

    wuyiulin@gmail.com

    2023-11-13 分層捲積的更新

    基於本部落格此篇文章的實現,

    雖然寫得有點醜但親測可用!

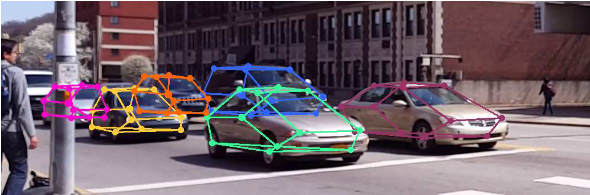
  • Occlusion-Net 用來解決物件遮蔽問題的 2D/3D 多視圖融合物件偵測方法

    Occlusion-Net 用來解決物件遮蔽問題的 2D/3D 多視圖融合物件偵測方法


    這是一個很有趣的方法,以我的觀點來看是跟 3D 點雲的 Multi-View 方法的延伸。

    主要是把 3D 點雲特徵用投影方法投回 2D 影像,
    利用 2D/3D 的融合特徵解決物件遮蔽的偵測問題。


    本篇數學推導較為艱澀,筆者在文中會推導重要部份。


    本文架構為四大 Loss值的組合。

    L_Keypoints:


    首先會先算 Keypoint Heatmaps,

    從一台車裡面算出 12 個點對標資料集的 Keypoint GT。
    (論文沒有細講,但個人從後面 KNN 猜測這裡做 L2  Norm。)


    L_Edge:


    在講 L_Edge 之前,我們要先定義 V 與 E:

    大V 是由 k 個頂點組成的關鍵點集合,
    而 V^l 代表 GT (真實的存在的關鍵點)、V^g 代表模型預測出來的關鍵點。

    E_ij 代表點i 與 點j 組成的邊,若點i && 點j 皆屬於關鍵點,則 E_ij 為 1、其餘為 0。


    把 V^g 還有 E_ij 拿去算三層的全連接層(FC)之後就會得到 E^l_ij。
    這邊要特別注意 V^l 代表 GT,但是 E^l_ij 代表模型算出來的邊。

    L_Edge 定義為:

    (-1)* sigma * E_ij * log(E^l_ij)

    L_Edge 的物理意義就是希望算出來的 E^l_ij 趨近於真實存在的 E_ij,
    這邊應該還蠻 trivial 的。


    L_Trifocal:


    這個 Loss 就複雜很多,我們要談到多視角融合的原理。

    首先我們要定義一個雙視圖:


    雙視圖解釋對極點


    圖中 C 代表第一攝影機,C’ 代表第二攝影機。
    第一視圖即是第一攝影機所看到的平面,第二視圖亦然。

    e 點即是第二攝影機在第一視圖上所代表的點,
    所以 e 點就是第二攝影機(C’ )對於第一攝影機(C)的對極點。

    要算出攝影機對極點需要攝影機內置矩陣 K,
    這個 K 矩陣牽涉基本矩陣 F,因為與本文較無關,筆者在此按下不表。

    有興趣了解的朋友,筆者推薦:

    “Multiple View Geometry in Computer Vision, 2/e, Richard Hartley” 一書

    中興的學弟可以修資工所吳俊霖老師開的影像處理,
    當年寫第一份作業就有寫到這部份。


    假設有三個攝影機照同一個 X點的三視圖


    現在我們有了攝影機矩陣 P、P’、P”:

    P = [ I  | 0 ]
    P’ = [ A | a_4 ]
    P” = [ B | b_4 ]

    a_i, b_i 代表攝影機矩陣的第 i 個 column。
    (如參照中國資料,那邊會說 column = 列,與臺灣直行橫列剛好相反,須注意。)


    以 P 當作觀察的攝影機來說,
    a_4, b_4 在此代表 P’, P” 攝影機在 P攝影機平面的對極點。


    讓 i 代表第i 個攝影機, a,b 代表非 i 的其他兩個攝影機,
    那麼三焦張量 T_i 的定義就是:

    T_i = (a_i)(b_4)^t – (a_4)(b_i)^t 

    所以 T 算出來應該要是 3x3x3 矩陣,可以自己推導一下。


    點線對應關係


    接下來我們要用三個視圖中的點線對應關係推導三焦張量的損失,

    兩關係式:

    • x” = H_13 * x
    • l = (H_13^t) * l”

    x” 為空間中 X點在第三視圖上的投影,
    H_13 矩陣實為第一視圖投影至第三視圖中的投影矩陣。


    H矩陣推導


    其中 H_13 = [h_1, h_2, h_3], h_i = T^t_i * l’。

    根據空間中的關係又可以推導出:

    H_12 = [T_1, T_2, T_3] * l”

    暫時看不懂 H_12 怎麼來的沒關係,先知道就好。


    因為 H_13 = [h_1, h_2, h_3], h_i = T^t_i * l’,
    所以 l = (H_13^t) * l” 
                -> l = ([T_1, T_2, T_3]^t * l’)^t * l”
                -> l = l’^t * [T_1, T_2, T_3] * l”


    skew-symmetric matrix

    接著因為三焦張量的特殊表達式,

    所以我們要複習一下大學線性代數 – 反對稱矩陣。

    先定義反對稱矩陣:

    任意矩陣 A 的反對稱矩陣 B 為 B = A^t – A,
    反對稱矩陣的特性為 B^t = (-1)*B。

    接著複習反對稱矩陣表達式:

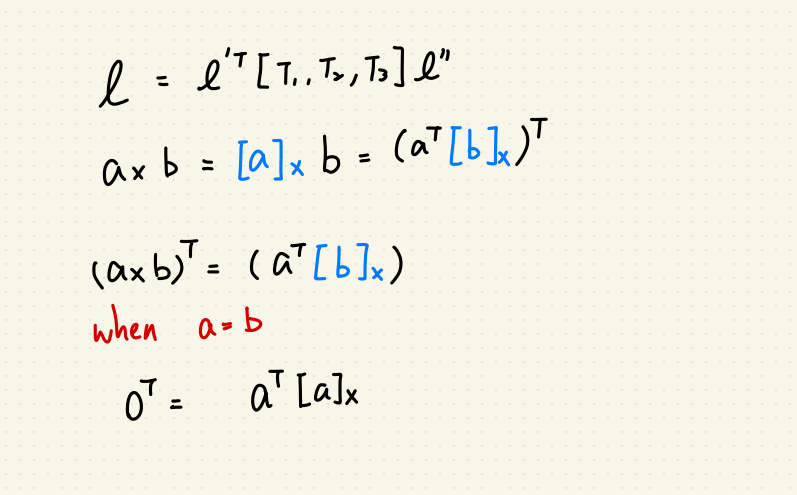
    Assume two martrix a, b,
    a cross b == [a]x * b == (a^t * [b]x)^t.

    又自己 cross 自己等於零,
    零矩陣的轉置是不是也是零矩陣?

    所以 0^t == [a]x * a == a^t * [a]x

    沒錯!不要猶豫!
    自信地把等式同乘 (-1)!

    筆者高中時就是班上最自信的那位,自信地讓高中數學被當!
    但是這裡真的可以同乘啦!

    以上複習完畢。


    由線推導點的投影 – 1


    由線推導點的投影 – 2

    由點投影關係式 x” = H_13 * x 為基底推導, 
    由上一段可知 H_13 = [T^t_1, T^t_2, T^t_3] * l’,
    則 x” = H_13 * x 
              -> x” = [T^t_1, T^t_2, T^t_3] * l’ * x 
              -> x” = sum(X_i * T^t_i) * l’ 
              -> x”^t = l’^t * sum(X_i * T^_i)

    由前段可知 a cross a 為零,所以:

    x”^t * [x”]x == l’^t * sum(X_i * T^_i) * [x”]x == 0^t

    接著我們要來拆解 l’,
    x’為空間中 X 在第二視圖上的投影,令 y’ 為第二視圖上過 l’ 的任意點。

    l’ = x’ cross y’ = [x’]x * y’
    l’^t = y’^t * [x’]x^t


    將  l’ 帶回等式


    由前段可知 l’^t = y’^t * [x’]x^t,
    將其帶回 l’^t * sum(X_i * T^_i) * [x”]x == 0^t

    -> y’^t * [x’]x^t * sum(X_i * T^_i) * [x”]x == 0^t

    由於 y 點可以為 l’ 上的任意點,所以 y’^t 可以消去,
    此段在”Multiple View Geometry in Computer Vision, 2/e, Richard Hartley” 一書中有證明,
    但為文章內容簡潔本文按下不表。

    又可利用 skew-symmetric matrix 性質:

    A^t = (-1)*A

    所以

    [x’]x^t = (-1)*[x’]x

    推導最終結果為:

    -> [x’]x *(sumx_i*T_i)*[x”]x = 0


    與三焦損失相比較:

    將不可視的模型預測點 V^g_j 與推導結果做 cross,
    若完美預測,則 Loss 為零。

    L_Trifocal 以上推導完畢。


    L_Reproj:


    這裡的 pi 是相機的內置矩陣,W為 3D空間預測點座標圖,

    這裡做 pi(W_j) 的物理意義是把 3D空間預測點座標圖投影回 2D平面,
    特別注意 V^g_j 也是 2D平面的座標預測點。


    Total Loss:


    最後把四個 Loss 加總起來就可以了 ODO!


    如何對本文有任何疑問或書寫錯誤,
    歡迎留言或是聯絡我:

    wuyiulin@gmail.com


  • Repulsion Loss 利用三項之力改善物件重疊問題

    Repulsion Loss 利用三項之力改善物件重疊問題

    最近小弟接到公司派的任務,
    主要負責解決物件重疊的問題。

    這篇算是我的物件重疊解法啟蒙之作,提筆紀錄一下。
     Repulsion Loss 主要是作者看到磁力作動所併發的想法, 
    (這說法跟牛頓他老爺子被林檎砸到有 87%像)
     所以 Repulsion Loss 主要有三個力(Loss)組成:

    • L_Attr          – 使 BBOX_pred 與配對到的 GT BOX 相近。
    • L_RepGT     – 使 BBOX_pred 遠離其他 GT BOX 。
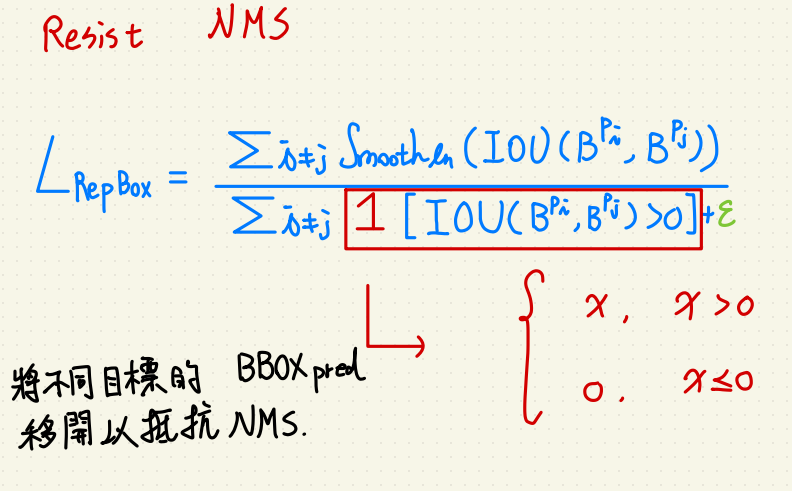
    • L_RepBOX  – 使 BBOX_pred_i 遠離預測其他出不同類別的 BBOX_pred_i,
                               可以避免因為距離太近,NMS 把框砍掉的問題。

    (至於 NMS 機制可以看這篇,我認為他講得很好。)

    Alpha 與 Beta 就有點 Focal Loss 的味道了,

    兩數和被一所約束。

    L_Attr

    L_Attr 的物理意義是使預測的框(BBOX_pred)與配對到的 GT BOX 接近。
    要算 L_Attr 就要先定義兩項集合:
    {G} = 所有的 GT BOX 集合
    {P}  = 所有正樣本的 Anchor 集合
    這裡簡單解釋一下 {P},就是所有包含前景的 Anchor 們,
    或是所有有物件、不是背景的 Anchor 們集合。
    這邊我也疑惑了一下什麼正樣本,有 BBOX 不就代表有物件了嗎?
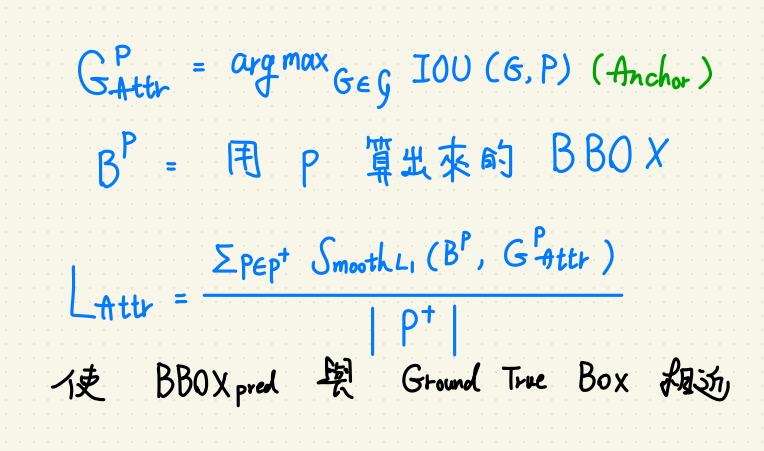
    接下來用 G, P 集合造 G^P_Attr:
    G^P_Attr = argmax_G∈G IOU(G, P)
    這個意義在於讓偵測到物件的每個 Anchor 都有一個家(GT BOX)。

    但是 G^P_Attr 畢竟還是一個對應關係,
    一個是 Anchor 、一個是 BBOX 還是不能算 Loss,
    所以利用 P 去做 B^P,也就是基於 P 的 BBOX。 
    接著用 L1_Smooth 造 L_Attr:

    L_Attr 結案!

    L_RepGT

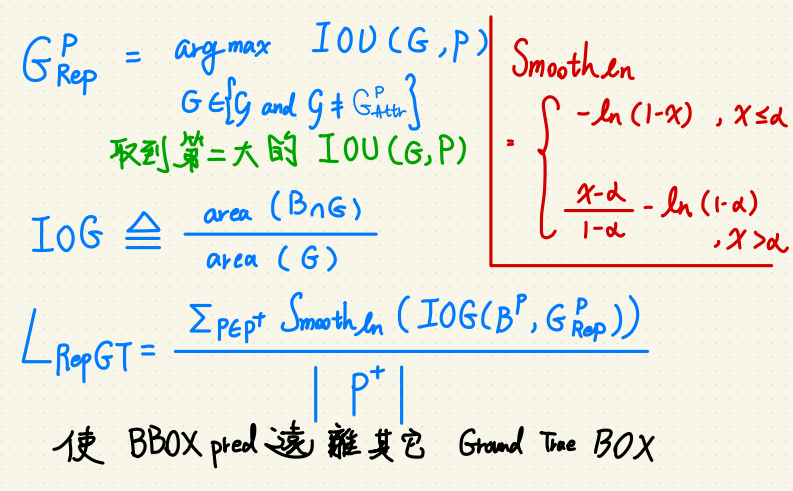
    L_RepGT 的物理意義是使預測的框(BBOX)遠離其他不屬於自己的 GT BOX。
    要算 L_RepGT 也要先求一個 G^P_Rep ,
    G^P_Rep 的物理意義是:
    對於該 BBOX_pred 來說 IOU 第二大的 GT BOX(最有機會的外遇對象)。
    我們為了阻止 BBOX_pred 外遇(#,
    所以把 G^P_Rep 算出來之後拿去與 B_P 做 IOG,
    再給它一個重疊度太高的懲罰權重。

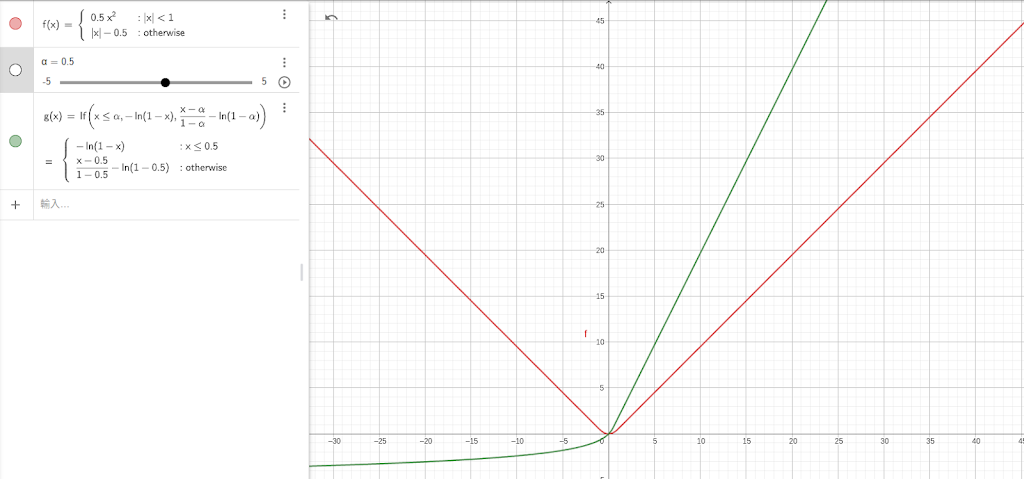
    至於這邊為什麼是用 Smoothln 而不是 SmoothL1
    綠色為Smoothln; 紅色為 SmoothL1;

    以下個人猜測:

    因為 IOG 的值域是 0-1,越趨近於 1 ,Loss 應該要越大。
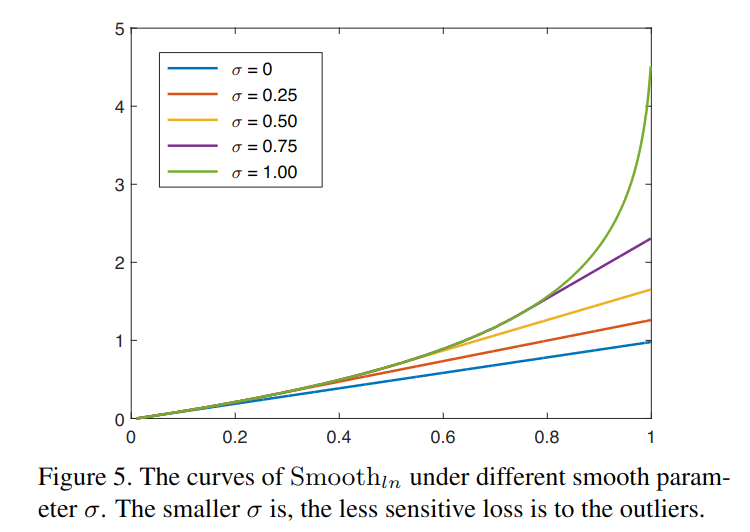
    Smoothln 看起來比 SmoothL1還好調整懲罰權重(調整 Alpha),
    而且驗證 IOG 會不會出錯的時候也比較好用。

    至於 Alpha 作為一個超參, Alpha 的值與對 outlier 的敏感度成正比。 

    L_RepBOX 


    這個 Loss 就比較直覺,主要提一下 1,想像成乘上步階函數,把小於零的地方除值。
    比較不同的是 x 為零時的定義為零。
    至於 epsilon 則是一個不為零的極小值,
    目的是為了抵抗分母為零造成數值 NaN 的梯度爆炸問題。
    以上,大概講一下我對於 Repulsion Loss 的理解。

    如果有問題歡迎聯絡我:
    wuyiulin@gmail.com

  • Quick Sort 利用快速排序法解決重複元素排序


    快速排序算法擁有最佳計算複雜度 O(n log n),

    但在特殊情況下會退化成 O(n^2)。

    其中一個特殊情況就是大量重複元素的排列問題。

    解決問題前,

    先介紹快速排序法的實現。

    假設你得到一隨機一維陣列要做升冪排序,

    最終的結果需要是這樣:

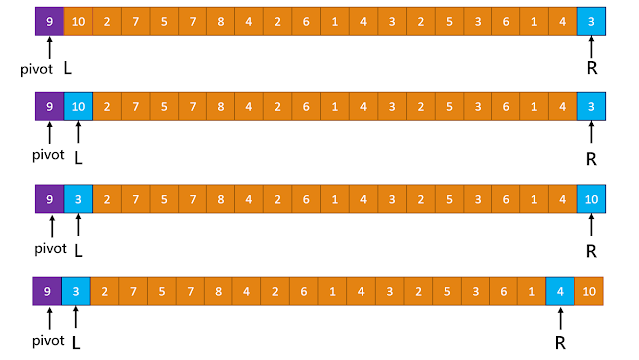
    選定隨機陣列最左側為 pivot ,pivot  為 L指標、最右側為 R指標。

    首先先判斷終止條件:R 的 index 是否等於 L 的 index?

    等於的話就將 pivot 的 值 與 R、L 的值交換,進行下一循環。

    R 的 index 不等於 L 的 index的話繼續尋找:

     R指標啟動尋找小於等於 pivot 的值,L 尋找大於 pivot 的值,找到就鎖定。

        若 R 的 index != L 的 index,則兩者的值交換。

    以此類推,當 R 的 index == L 的 index 時,交換 pivot 與 R 的值。
    並以交換點為準,分割左邊右邊兩個子循環。

    這邊可以順便推導為什麼 quick sort 的計算複雜度為 O(n log n),

    因為相較於 bubble sort 中每個 pivot  要比較 n-1 個元素,

    quick sort 在第二次以後的理想狀況每個 pivot 只需比較 (n/2)^m個元素
    (m=排序次數-1)。

    所以最佳計算複雜度才會是 O(n log n)  // n個 pivot 乘上該次比較元素量。

    但是齁,人算不如天算。

    有時候就會遇到很棘手的情況,讓 quick sort  一點都不 quick。

    主要分為兩種:

    1. 已排序數列。
    2. 存在著大量重複元素的數列。

        1.已排序數列。

    已排序數列的問題在於分割的左右子陣列不平衡,
    導致需要搜尋的元素趨近於 n。
    如此一來計算複雜度便會退化成 O(n^2)
    解法:把數列打亂即可解決這個問題。


        2.存在著大量重複元素的數列。

    這個就比較麻煩了,因為打亂也解決不了(#。
    這個問題在於要搜尋相等於 pivot 的重複數,
    兩數之間總共有三種關係嘛:大於、等於、小於。
    之前的方法一直把等於的方法掛在 L指標上面做,
    解決問題的核心精神是特別考慮等於的情況處理。

    重複數處理範例:


    令 pivot 為最左側的 index,L的 index 等於 privot +1,R 的 index 為最右側的 index。

    一樣先判斷 L 有沒有大於 R?

    沒有的話 L 先搜尋,分為三種情況:


    1.L中的元素比 privot 還要小:
        L 與 pivot 交換元素。
        
    privot++
        L++

    2.L中的元素等於 privot :
         L++


    3.L中的元素大於 privot :
         檢查 R元素
            R元素 大於  pivot:
                R–
            R元素 等於  pivot:
                L元素 與 R元素交換
                R–
                L++
            R元素 小於  pivot:
                L元素 與 R元素交換
                R–
                L元素 與 
     pivot交換
                privot++
                L++


    #include <stdio.h>
    #include <stdlib.h>
    #include <time.h>
    #include <iostream<
    #include <vector<
    #include <algorithm<
    #include <random<
    
    void swap(int *array, int i, int j) {
        
        array[i] = array[i] ^ array[j];
        array[j] = array[i] ^ array[j];
        array[i] = array[i] ^ array[j];
    }
    
    void quicksort(int *array, int left, int right) {
            if (left >= right) 
            {
                return;
            }
            int P = left;
            int L = left;
            int R = right;
    
            while(L <= R)
            {
                if(nums[L] < nums[P])
                {
                    swap(nums, L, P);
                    L++;
                    P++;
                }
                else if(nums[L] == nums[P])
                {
                    L++;
                }
                else
                {
                    if(nums[R] > nums[P])
                    {
                        R--;
                    }
                    else if(nums[R] == nums[P])
                    {
                        swap(nums, R, L);
                        swap(nums, L, P);
                        R--;
                        L++;
                    }
                    else
                    {
                        swap(nums, R, L);
                        swap(nums, L, P);
                        R--;
                        L++;
                        P++;
                    }
                }
            }
            quicksort(nums, left, P-1);
            quicksort(nums, P+1, right);
    }
    
    int main() {
        int ARRAY_SIZE = 100;
        int array[ARRAY_SIZE];
    
        // 設定隨機種子
        srand(time(0));
    
        // 生成隨機一維陣列
        for (int i = 0; i < ARRAY_SIZE; i++) {
            array[i] = rand() % 11; // 生成 0 到 100 之間的隨機整數
        }
    
        printf("原始陣列:");
        for (int j = 0; j < ARRAY_SIZE; j++) {
            printf("%d ", array[j]);
        }
        printf("n");
    
        quicksort(array, 0, ARRAY_SIZE - 1);
    
        printf("排序後:");
        for (int j = 0; j < ARRAY_SIZE; j++) {
            printf("%d ", array[j]);
        }
        printf("n");
    
        return 0;
    }


    好,大功告成!

    你現在可以用 Quick Sort 面對多重複元素的排列問題了!